学习心得
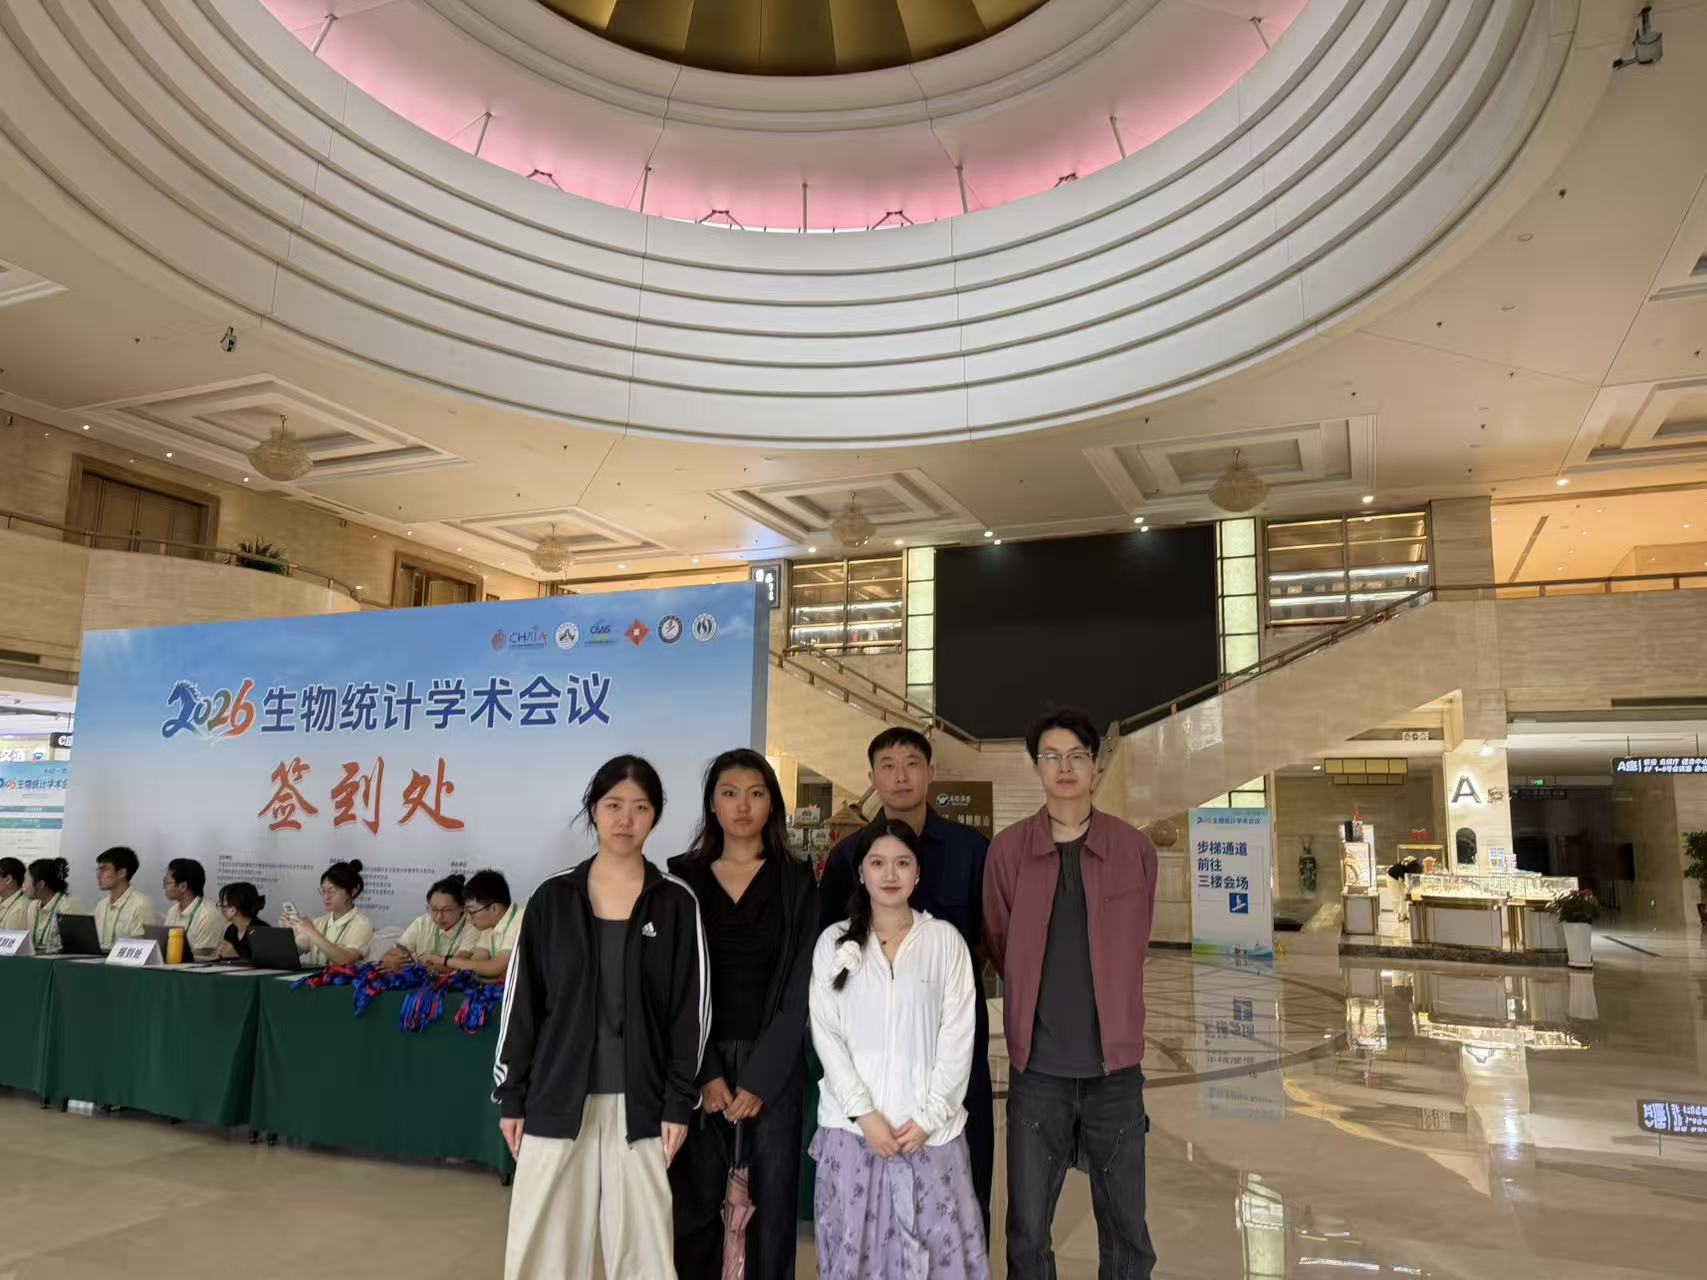
2026年生物统计学术会议期间,我听了「慢病健康风险评估与统计分析」专题。中山大学公共卫生学院(深圳)刘斯洋副教授以《从数据拟合到临床决策:脑卒中预测模型的方法学进展与转化挑战》为题,介绍了团队在卒中预后预测上的一系列工作。整场报告的落点并不在展示某一个模型有多好,而是回到一个更靠前的问题:文献里已经发表了那么多临床预测模型,为什么真正走进病房、改变一次处置的仍然很少。
模型写得很多,能拿到床旁用的很少
报告先按使用场景把卒中预测模型分成三类。发病之前,用来做风险筛查,熟悉的名字有 Framingham、CHA2DS2-VASc。急性期,用来帮助诊断和分流,如 FAST、RACE、LAMS。确诊并开始治疗之后,用来估计复发、残疾和死亡,如 IScore、ASTRAL、PLAN。刘老师把重点放在第三类,也就是预后预测。
他把既往文献系统梳了一遍,给出的数字让人很难再用「这个领域已经很成熟」来安慰自己。卒中复发预测模型中,AUC 超过 0.8 的只有 5 个。完成过外部验证的更少:15 个复发模型里一个也没有,12 个残疾模型里只有 2 个,9 个死亡模型里只有 1 个。多数研究既没有报告校准度,也没有做决策曲线分析。这些模型大多只在建模的那一批人里检验过,换到另一群人身上表现如何,证据是空的。论文里报出来的区分度,也很可能因为过拟合而被抬高了。
我听完这一段,记下的不是「还要再追求一个更高的 AUC」,而是评价标准要一起看。区分度只说明模型还能不能把人排个序。校准度决定报出来的概率可不可信,外部验证决定换人群之后还站不站得住,临床效用决定医生用了它,决策会不会真的更好。少了后面几项,模型可以发表,却很难被信任,更谈不上被使用。
以 DISCO 为例,看一个模型怎样走完四步
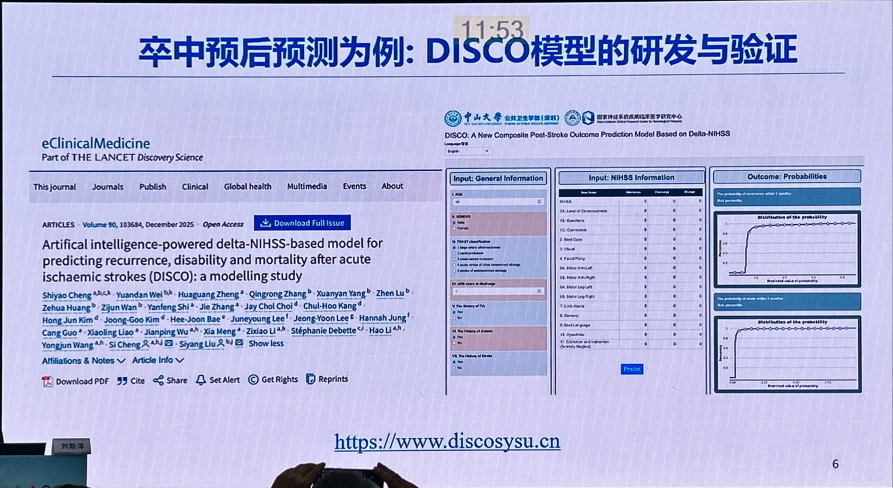
针对上面这些缺口,报告用团队发表在 eClinicalMedicine 的 DISCO 模型,把「从数据到能打开的工具」完整走了一遍。我按自己的理解,把它收成四个环节。
第一是数据基础。研究基于中国国家卒中登记 III(CNSR-III),最终纳入 13,940 例急性脑卒中患者,采集了 309 项临床特征,最长随访 5 年,主要终点是发病后 3 个月的复发、残疾与死亡。刘老师强调,样本量、随访时长和变量维度,在动手建模之前就已经把性能的上限定下来了。算法再换,也补不上一份跟不上临床问题的数据。
第二是防止过拟合。报告里有一个很直观的例子:用多项式去拟合同一批数据,阶数提到 9 次时,训练误差可以降到 0,参数却变得极大,模型一到测试集就基本失效。为了避开这种「练得很熟、一上场就不会」的情况,研究做了三件事。一是采用嵌套交叉验证,把超参数调优和性能评估拆开,不用同一份数据既调参又给自己打分。二是在内部按 8∶2 分出训练集和独立的测试集。三是另外找了两个外部人群,分别是 CHANCE-2 临床试验的数据和韩国卒中登记队列。内部留出的测试集仍然和训练数据来自同一登记系统,外部队列才是真正换了人群、换了场景的检验。
第三是算法选择。候选包括 Logistic 回归、随机森林、XGBoost、支持向量机、朴素贝叶斯,以及基于预训练 Transformer 的表格基础模型 TabPFN,最终以 XGBoost 表现最好。这里让我停下来想的是:选择依据不是算法新不新、复杂不复杂,而是它适不适合眼前这批表格数据。树模型本来就擅长处理变量之间的共线和非线性,表现好是有原因的。把一个更新的模型名字写进摘要,并不能代替这一步比较。
第四是特征与可解释性。特征重要性分析里,排在第一位的变量是 ΔNIHSS,也就是入院与出院之间 NIHSS 评分的变化量,而不是某一次测量的绝对值。这在临床上说得通:神经功能是在好转还是在恶化,比入院时有多严重,更能说明后面的预后。也因此我意识到,把变量构造好,有时比再换一个更复杂的算法更有用。如果不主动把「变化量」这个有临床含义的变量算出来,指望算法自己从两次原始评分里发现它,并不现实。
模型要能被打开,才谈得上改变一次决策
报告最后介绍了团队开发的在线风险评估工具,网址是 https://www.discosysu.cn。预测模型的价值,终究要落到会不会改变临床决策。如果医生不能方便地打开它,看不到眼前这名患者的风险概率,也看不到公开的验证证据,论文里的 AUC 再高,也很难在查房时被用上一次。把模型封装成可以交互、可以复现的工具,同时意味着整个研究过程必须经得起别人核对:数据从哪来、变量怎么定义、验证做在哪些人群上,都得能对上。
听完之后
学术上,这场报告借给我的是一套评价习惯,而不是某一个算法的名字。以后再读临床预测模型的论文,我会先问有没有外部验证、有没有校准、有没有决策曲线,而不是先被摘要里的 AUC 说服。DISCO 把嵌套交叉验证、内部留出测试集和两个外部队列放在同一项研究里,也让我看到:方法学上的严谨,是可以按步骤写进方案的,不必停留在讨论部分的一句「有待进一步验证」。
对后面自己的研究,可参考的地方更具体。若课题涉及到预后或风险分层,数据规模和随访长度要在设计时就想清楚,不要等模型做完才发现上限在数据那里。变量不要只堆入院时的一次测量,病程中的变化、治疗前后的差值,往往比绝对值更接近临床判断。算法可以多比较几种,包括传统回归和树模型,但比较的标准是适不适合这批数据,不是新不新。研究若做到可以给临床用的程度,还应当考虑做成能够打开的工具,并把验证证据放在工具旁边,而不是把「开发完成」当作终点。
我自己最大的体会是视角换了。过去读这类论文,容易把「模型做出来、指标好看」当成结束。刘老师把问题倒过来说:可被信任、可被临床理解、可被实际打开来用,这三件事才是模型有没有完成的标准。统计指标仍然要做,而且要做全;只是它们服务于后面那三件事,不能代替它们。这场报告我记下的,就是这个次序。
 陕公网安备61011302000964号

 扫码关注公众号

