学习心得
2026年生物统计学术会议专题六上,我听了刘铱老师的报告《基于高分辨率暴露预测的细颗粒物与结核病发病风险关联研究》。整场报告并不急着给出一个「污染越高、发病越多」的简单结论,而是先把方法学上的缺口摆出来:人群研究里暴露测得粗、时空异质性又被忽略时,后面估出来的健康效应很难让人放心。刘老师给出的答案,是一条从高精度暴露建模走到贝叶斯时空健康风险评估的完整链条。
结核防控压力仍在,既往关联研究却常「测不细」
结核病由结核分枝杆菌引起,至今仍是全球单一传染源死亡率最高的疾病之一。我国又是全球第三大结核高负担国家。已有研究提示,大气细颗粒物(PM2.5)可以直接损害呼吸系统,还可能通过抑制肺泡巨噬细胞免疫应答、加重呼吸道炎症,促进感染与疾病进展。问题不在「要不要关心空气污染」,而在「群体真实吸到了多少、风险随时间和地点如何变化」。
刘老师梳理既往人群研究时指出,局限主要有两处。一是暴露评估偏粗,多依赖区域内有限监测点的算术平均,难以反映人群真实暴露,偏差会一路传到关联估计里。二是健康风险评估容易被混杂因素干扰,尤其是忽略时空异质性时,效应估计会出现偏倚,说不清真实情况。我听完这一段,记下的不是又多了一条「污染有害」的常识,而是:关联能不能站住,先取决于暴露有没有被测到该测的分辨率上。
双阶段框架:先把街道级浓度估出来,再估发病风险
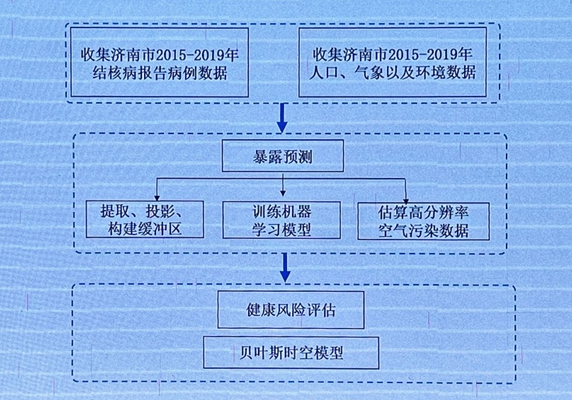
针对上面的缺口,报告给出了「高分辨率暴露预测—贝叶斯时空健康风险评估」的双阶段框架。我按自己的理解,把它收成三步。
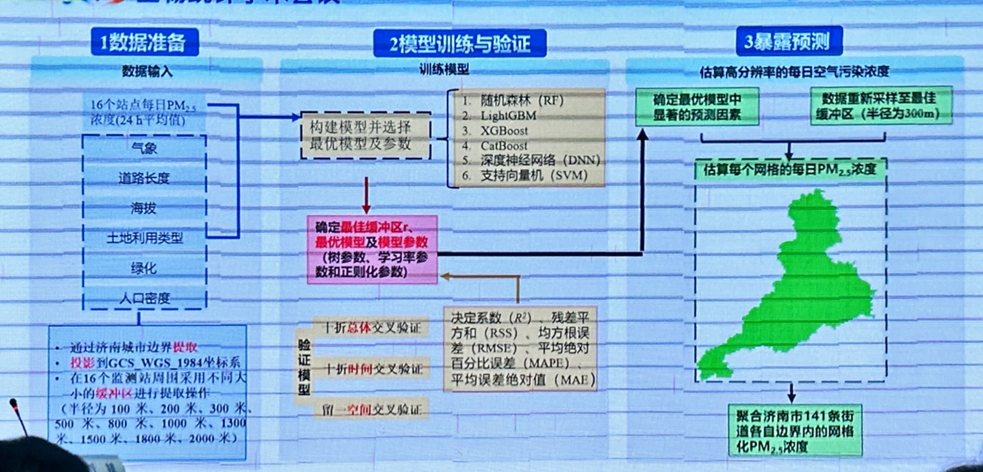
第一步是多源数据融合,做街道级高精度 PM2.5 浓度预测。研究覆盖济南市 2015–2019 年 8 区 2 县共 8,291 例新发活动性肺结核病例,并整合气象、道路长度、海拔、土地利用类型、植被覆盖度(NDVI)和人口密度等数据。算法上比较了随机森林(RF)、LightGBM、XGBoost、CatBoost、深度神经网络(DNN)和支持向量机(SVM),最终在最佳缓冲区半径 300 m 下,以 XGBoost 表现最好,交叉验证 R² 达到 0.89–0.90,从而估出街道级高分辨率 PM2.5 日浓度。SHAP 解释进一步标出关键预测因子:滞后 1 天的 PM2.5 浓度、年内日序数和露点温度。
第二步是用基于 INLA 的贝叶斯时空模型量化健康风险。针对 141 个街道的每日病例计数,团队构建负二项分布下的贝叶斯时空模型,用集成嵌套拉普拉斯近似(INLA)做高效拟合,并比较基础模型、协变量调整模型、Besag-York-Mollié(BYM)空间结构模型及时空交互模型。引入空间结构效应与时空交互项后,DIC、WAIC、Log-score、MLIK 等拟合优度指标均有改善,降低了因忽略空间自相关和时间趋势带来的估计偏差。
第三步是看滞后效应和谁更敏感。结果显示,PM2.5 短期暴露显著增加结核发病风险,效应在滞后第 3 天达到峰值(IRR = 1.019,95% CI:1.009–1.029)。稳健性检验、零膨胀负二项模型,以及城市 / 区 / 街道三级空间尺度对比下的亚组与敏感性分析,方向保持一致;老年人(≥65 岁)、女性、寒冷季节和农村居民对 PM2.5 短期波动更为敏感。
这三步连在一起,回答的是同一件事:暴露测细了,时空结构写进模型了,关联才更站得住,也才谈得上谁在什么时段更该被看见。
听完之后
学术上,这场报告借给我的是一套「先问暴露分辨率、再问效应模型」的阅读顺序。以后再读环境因素与传染病关联的论文,我会先看暴露是监测点平均还是网格 / 街道级预测,有没有报告交叉验证表现;健康结局一侧,则看有没有认真处理空间自相关与时间趋势,而不是只盯着一个 IRR 是否显著。机器学习负责把浓度估细,贝叶斯时空模型负责把风险估稳,两者分工清楚,比把「算法新」当成全部贡献更可信。
对后面自己的研究,可参考的地方很具体。若课题涉及环境暴露与发病,数据清单里除了病例,还要尽早准备气象、土地利用、植被和人口等协变量,并事先想好缓冲区或网格尺度怎么选、怎么验证。模型比较不要只报训练集好看,十折、时间交叉验证、空间留一这类设计,报告里写得很清楚,方案里可以直接对照。识别高危亚组时,年龄、性别、季节与城乡可以按同样逻辑预设,而不是结果出来后再找故事。
我自己最大的体会是,环境健康题目里「关联显著」和「测得够细」不是一回事。过去容易觉得有了病例和污染指标就能回归;刘老师把问题倒过来说:暴露测粗了,后面的健康效应再漂亮,也难经得起时空结构的追问。统计与机器学习的交叉,不是把名词叠在摘要里,而是让预测精度和服务于防控的风险估计落到同一条可核对的链条上。这场报告我记下的,就是这条链条该怎么搭。
 陕公网安备61011302000964号

 扫码关注公众号

