新闻动态
整理医疗数据和研究资料时,删除姓名、电话等字段后,仍要检查备注、标题和正文中的身份信息。如果只按关键词替换,又可能把需要保留的业务内容一起删掉。围绕这些问题,我们在团队的 Debian 主机上部署了 Presidio,尝试将自动识别与人工复核接入资料处理流程。
这轮工作包括本地工具开发、合成数据测试和两份指定文档的适配。
先找出位置,再执行替换
Presidio 的处理分为两步。Analyzer 找出文本中疑似敏感信息的位置和类型。Anonymizer 再按指定方式处理这些位置,例如替换为统一标记,或遮蔽部分字符。团队这次采用统一替换,输出标记为 <REDACTED>。
识别时,我们同时使用语言模型和规则。模型根据上下文寻找人名、地点等实体,规则识别手机号、邮箱等有格式特征的内容。两者的结果会有重叠。例如,邮箱的一部分也可能被识别为网址。我们在适配代码中先合并重叠位置,再交给 Anonymizer 替换,避免分次处理留下残余字符。
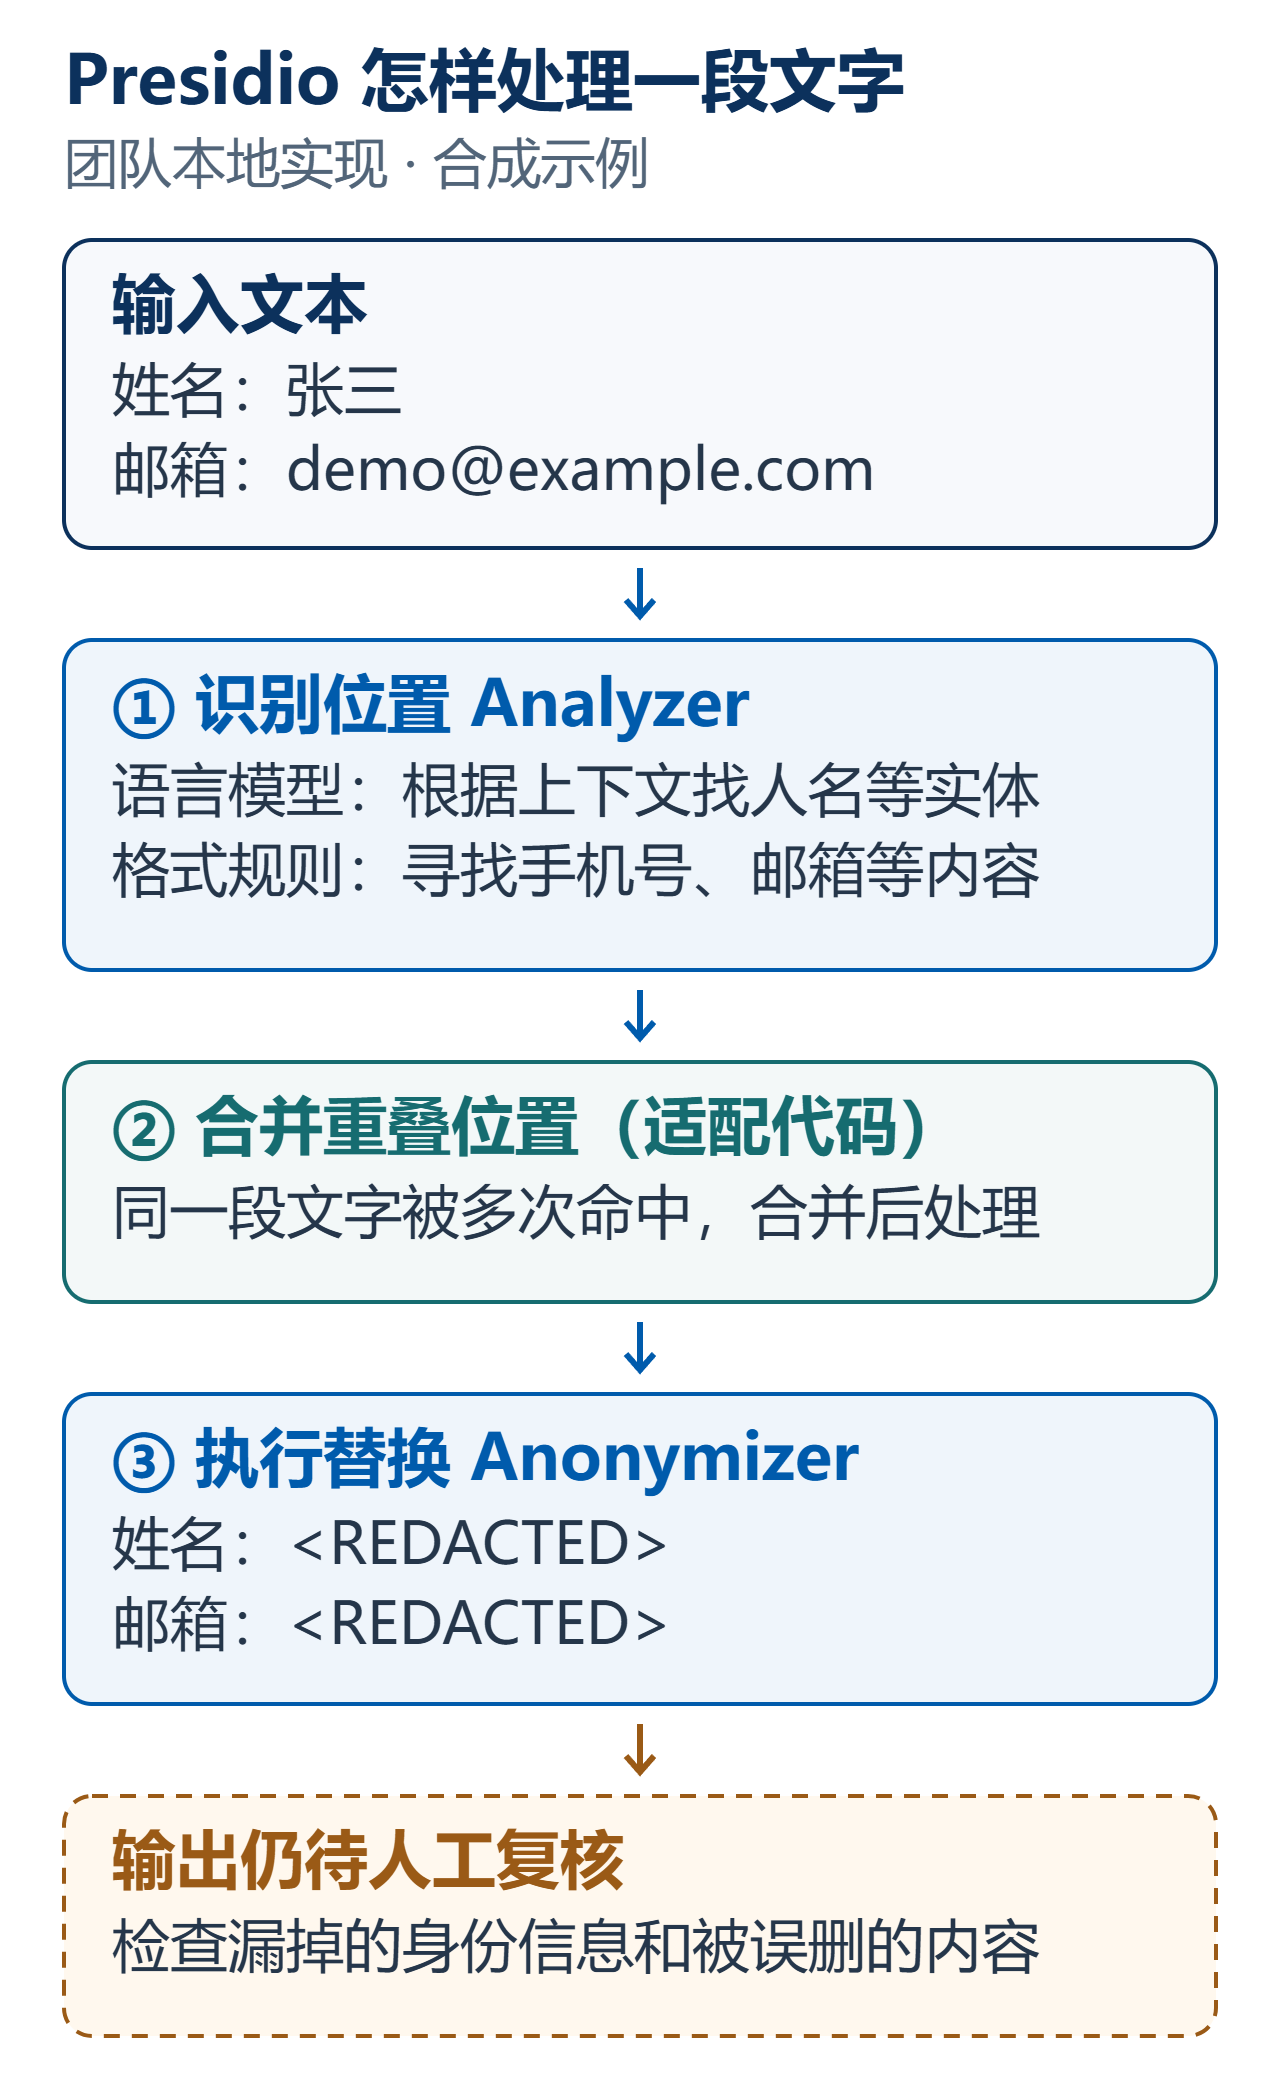
图中使用合成文本说明处理方式。标记被替换后,仍需检查有没有漏掉的身份信息,以及有没有误删研究所需的内容。
中文材料要补模型,也要补规则
Presidio 的默认配置面向英文。我们另外安装了中文 spaCy 模型,并补充中文手机号、疑似身份证号码、邮箱和带“姓名”上下文的识别规则。中英文混合材料分别扫描,再合并结果。
文档适配中遇到过带职称的姓名,我们为此增加了局部识别规则和测试用例。但姓名不能完全靠固定格式判断,无上下文姓名、少数民族姓名和别名仍可能漏检。身份证规则也只检查疑似号码的格式及部分日期范围,不核验身份真伪。
另一个问题是误删。处理方法类文档时,“P:计划、目标”等通用标签需要保留,日期和机构名称则要结合用途判断。我们将这次文档适配的自动替换范围收窄到选定的直接身份类型,再核对段落、表格结构和通用字段。具体安排等内容即使没有被替换,也仍留在内部复核范围内。
实际文件怎样处理
工具每次读取明确指定的文件,原件保留,处理结果另存。普通文本、JSON 和 CSV 由本地命令行工具处理。两份指定的 Office 文档先抽取结构和文字,再执行局部适配,得到供复核的结构化内容。
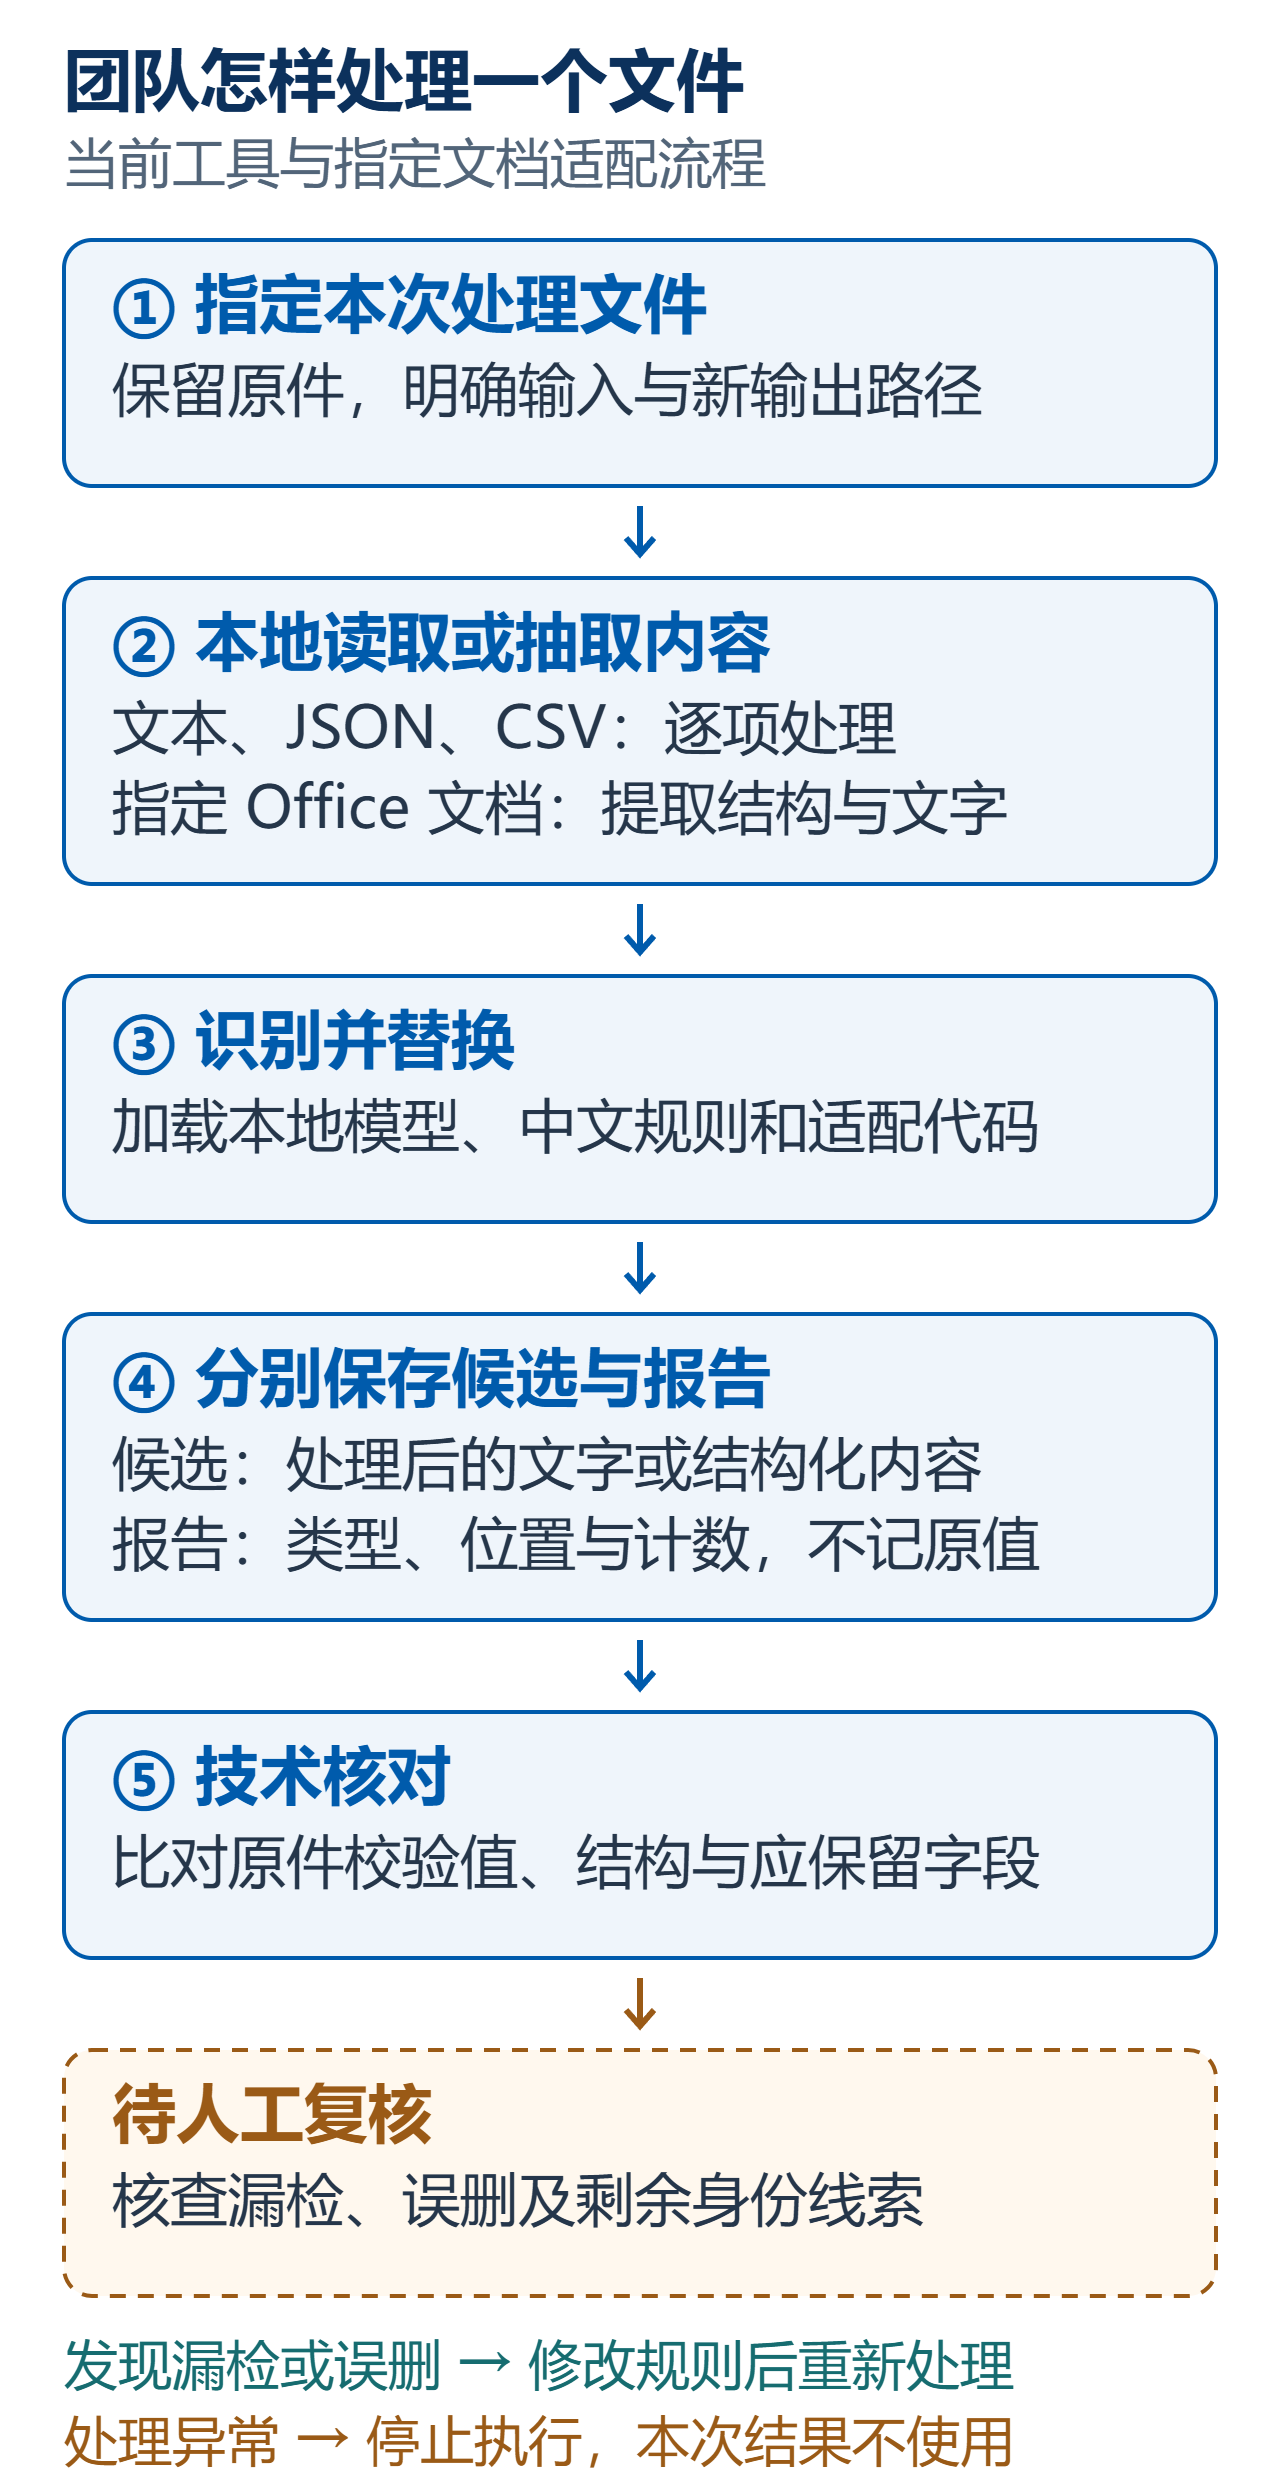
我们同时保存候选文件和处理报告。报告只记录命中类型、位置和数量,不记录姓名、邮箱等原值。技术核对包括检查原件校验值,以及文档结构和应保留字段是否完整。此次读回核对中,两份原件未改动,16项指南字段完整匹配。输出为结构化候选,没有复刻原 Office 版式。
所有成功输出都标为 requires-review,即“待人工复核”,没有命中的文件也一样。人工还要检查地址、病历号、特殊经历及多字段组合中的身份线索。发现漏检或误删后,修改规则,再用同一份原件重新处理。
文件处理有异常时,工具停止执行。例如,输入输出指向同一路径、输出文件已经存在、JSON 出现重复键、CSV 行宽不一致,都会被拒绝。这样可以避免覆盖原件,也便于定位数据结构变化。候选文件缺少成功报告时,不进入后续使用。
本地运行还要检查哪些环节
我们采用独立 Python 环境,提前安装中英文模型。处理文件时不调用远程模型,也不启动 HTTP 服务。缺少模型时直接报错,不在处理中下载。
排查依赖时还发现,域名后缀解析库可能尝试联网更新后缀列表。我们改用本地资源,并在合成测试中阻断 socket 连接和 DNS 解析,检查选定输入能否完成处理。候选文件和报告只允许当前用户访问,错误日志不输出原文。后续更换依赖或模型时,这些环节也需要重新检查。
2026年10月6日的验收记录中,基础功能和文档适配共通过31项合成测试,覆盖中英文处理、重叠位置、结构保留、原件保护和异常停止等情况。它们验证的是软件行为。进入医疗文本试用后,还需要用获准且经过人工标注的样本,评估不同类型信息的漏检、误报和研究变量保留情况。
目前统一替换的方式适合清除文本中的直接身份值。若研究需要关联同一对象的多次就诊,还要单独设计研究编号和受限保存的映射表,不能依靠统一的 <REDACTED> 标记完成关联。
技术资料:Presidio 官方文档、多语言配置、自定义识别器、脱敏操作。两张图由团队依据官方说明和本地实现绘制。
供稿:米白冰
审校:冉竹逸
终审:米白冰
 陕公网安备61011302000964号

 扫码关注公众号

