
新闻动态
在2026年生物统计年会专题二中,我听了复旦大学附属中山医院黄丽红老师题为《基于双向阴性对照的近端因果推断方法学研究》的报告。整场报告的逻辑非常清晰:先回到因果推断最核心的难题——未测量混杂,再介绍团队前期在经验P值校正法上的成果,随后转向不依从RCT中的双阴性对照(DNC)应用,最后重点讨论Reg-PCI方法的两个关键问题及其改进。听完之后,我最大的感受是:因果推断的方法学创新,并不是简单追求模型更复杂,而是不断追问“在什么假设下,我们到底能识别什么”。
报告背景与前期基础
报告开头先点明,已测量混杂可以用IPW、倾向性评分等方法处理,但前提是所有重要混杂都已测量;而工具变量、孟德尔随机化虽可用于未测量混杂,却面临有效工具变量难获得、弱工具变量导致估计不稳定等问题。阴性对照因此成为近年来的新策略:阴性暴露对照(NCE)已知对结局无因果效应,阴性结局对照(NCO)已知不受暴露因果影响,二者与暴露-结局共享相似的混杂结构,即U-可比性。黄老师团队前期在《Journal of Clinical Epidemiology》发表的经验P值校正法,正是通过多个单向阴性对照构建经验零分布,对P值进行校正。其结论也很实在:优先选择满足U-可比性的阴性对照,质量优先于数量;若存在轻度混杂,至少纳入10—15个阴性对照,重度混杂建议30个以上;而且该方法并非总是降低检验效能,当偏倚方向与真实效应方向相反时,反而可能提高效能。
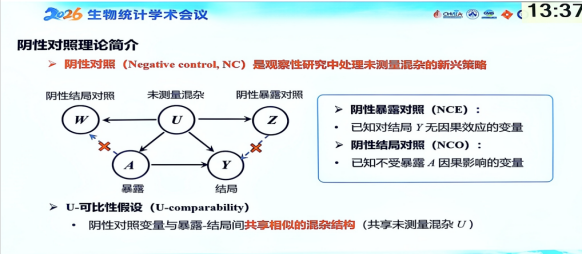
图1 阴性对照理论
DNC应用与Reg-PCI改进
接着,报告将DNC用于外科RCT中的不依从问题。外科RCT中,患者可能从手术组转到保守治疗组,或反向交叉,按实际治疗分析会引入未测量混杂。传统ITT、PP、AT各有偏倚,IV在低依从、小样本时MSE急剧增大,DiD在假设违反时明显不适用。DNC则通过建立混杂桥函数,同时利用NCE和NCO,在GMM矩条件下识别实际治疗效应。模拟研究基于SPORT试验参数,显示DNC在偏倚、MSE和覆盖率上均表现稳定,小样本下依然稳健。这让我意识到,DNC的价值不在于“替代RCT”,而在于为不依从场景提供敏感性分析工具。
报告的核心部分是对Reg-PCI的介绍与改进。Reg-PCI采用两阶段回归:第一阶段建立NCO(W)对暴露A、NCE(Z)和已测量混杂X的回归,第二阶段用W的预测值估计结局Y。但它有两个关键问题:一是假设暴露与结局严格线性,忽略U型、阈值、S型等非线性剂量-反应关系,导致模型设定偏误不随样本量增大而消除;二是忽略未测量效应修饰,即暴露效应可能随未测量混杂U变化,直接使用会加剧主效应偏倚。针对前者,黄老师提出Spline-PCI,用样条函数s_A(A)自适应估计剂量-反应曲线;针对后者,提出PCI-UEM,引入A×W交互项,在估计主效应的同时检验未测量效应修饰。模拟结果显示,Spline-PCI能恢复分段线型、抛物线型、S型、正弦波动型等曲线;PCI-UEM的主效应偏倚接近金标准Oracle,交互效应I类错误稳定在0.05附近。
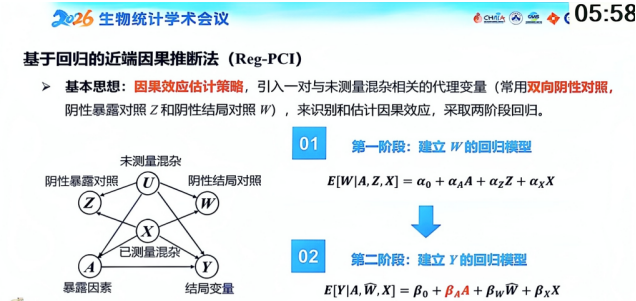
图2 基于回归的近端因果推断法(Reg-Pci)两阶段回归模型
对“识别”更具体的理解
以前我阅读因果推断方法学文献时,常被公式和模型吸引,容易忽略作者为什么这样设定假设,总觉得方法越复杂越可靠。但黄老师整场报告都在强调“在什么假设下能识别什么”,这让我意识到,识别和估计是两回事。识别是理论层面的问题:目标因果量能否从观测数据中唯一确定;估计是统计层面的问题:有了识别公式后,用样本去估计它,并评价偏倚、方差和覆盖率。如果识别不成立,再复杂的模型也只是在拟合数据,估计不出真正的因果效应。这一点对我触动很大。
另一个收获是,阴性对照的选取需要非常谨慎。报告中反复强调U-可比性,说明阴性对照不是随便找两个变量就行。它必须与目标暴露-结局共享相似的混杂结构,否则提供不了关于未测量混杂的信息,校正也就无从谈起。以前我常把阴性对照当成一种技术性操作,觉得只要有变量就行。现在我才明白,阴性对照的质量直接决定方法能否成立,而质量依赖领域知识和DAG验证,不能靠数据驱动乱选。
报告中的模拟研究设计也让我印象深刻。无论是DNC用于不依从RCT,还是Spline-PCI和PCI-UEM的改进,黄老师团队都设置了多种场景:不同样本量、不同交叉率、不同混杂结构、不同曲线形态。这种细致的模拟不是为了展示方法多好,而是为了看清方法在什么条件下稳健、在什么条件下失效。我从中体会到,方法学论文的严谨不仅体现在公式推导上,也体现在对假设边界的诚实检验上。
Spline-PCI和PCI-UEM的提出,让我看到方法创新的另一种路径。它们不是凭空造一个新模型,而是针对Reg-PCI的两个具体局限:线性假设和未测量效应修饰。Spline-PCI用样条函数自适应估计剂量-反应曲线,PCI-UEM引入A×W交互项检验效应修饰。这些改进并不花哨,却直接回应了真实数据中常见的非线性与异质性。黄老师把前期经验P值校正法的应用建议讲得很具体,比如轻度混杂至少10—15个阴性对照,重度混杂建议30个以上,这种可操作的建议在方法学报告中并不多见,也让我觉得这些方法离实际研究并不遥远。
整场报告听下来,我印象最深的是黄老师团队对待方法学问题的态度:不是急于推出新方法,而是先看清旧方法在哪些场景下会失效,再针对性地改进。无论是经验P值校正法对阴性对照质量与数量的建议,还是Spline-PCI对非线性关系的处理、PCI-UEM对效应修饰的检验,背后都是一种务实的研究逻辑——把假设讲清楚,把边界划明白。这种思路让我意识到,做研究不一定要追求多么复杂的模型,但一定要清楚自己的方法适用于什么条件、不适用于什么条件。这对我今后阅读文献和开展分析都有很大启发,也是我此次参会最实在的收获。
供稿:潘利平
审校:冉竹逸
终审:米白冰
 陕公网安备61011302000964号

 扫码关注公众号

