
新闻动态
听完方积乾教授的《基于医保数据的真实世界研究》报告,我最强烈的感受是:医保数据远不只是“报销流水”,而是一座覆盖全人群、连续、多维度、低成本的真实世界证据金矿。但要把这座金矿变成可信证据,靠的不是数据量本身,而是严谨的研究设计、因果推断方法和合规治理意识。
报告用“国外研究——热闹,已遍地开花”“若干案例——不难,却颇有价值”“国内研究——不多,却大有希望”三个部分,勾勒出这一领域的全球图景和中国机会。国外研究已覆盖肿瘤、自身免疫/罕见病、慢性病和卫生经济等广泛领域,例如肺癌筛查依从性、子宫内膜癌铂后治疗、银屑病全身治疗、尿路上皮癌资源利用、前列腺癌费用、视神经脊髓炎管理、轻链淀粉样变性诊断模式、类风湿关节炎归因费用等。这些案例说明,医保数据可以回答临床效果、医疗资源利用、疾病负担和流行病学等多类问题。
几个具体案例让我印象很深。德国法定保险数据对SLE患病率、发病率和管理的研究,展示了医保数据在流行病学监测中的价值;胰岛素与GLP-1 RA、DPP-4I、SGLT2I比较5年心衰风险的研究,则通过逆概率加权和双重稳健估计,尽量逼近因果结论;台湾中医药治疗与II型糖尿病血管并发症的研究,在匹配校正后显示中医组中风发生率约为非中医组的67%,且治疗≥180天者风险降低更显著。这些结果不一定“惊天动地”,却很有临床和决策价值。
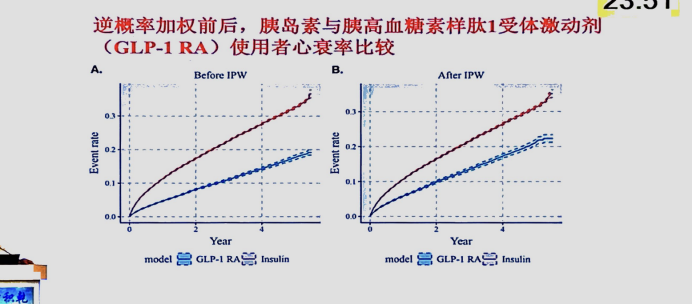
更让我警醒的是方法学部分。报告强调的新用户设计避免永生偏倚、倾向性评分匹配/加权校正混杂、硬终点指标、敏感性分析验证稳健性,都是真实世界研究的生命线。观察性医保数据天然存在选择偏倚、混杂和时间偏倚,不能把关联直接当成因果。真正的研究水平,体现在设计是否严谨、估计是否稳健、结论是否经得起敏感性分析。
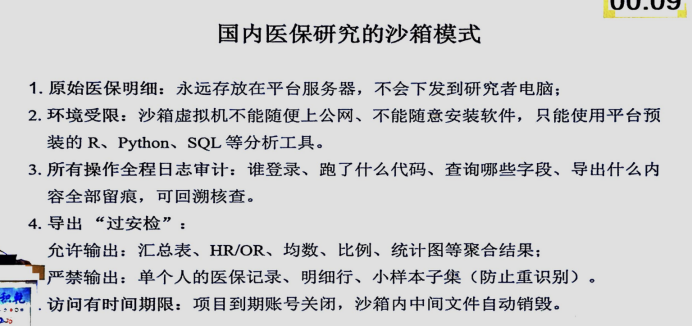
国内部分则让我看到希望与边界。中国已建成全国统一医保信息平台,覆盖全体参保居民、超100万家定点医院/药店,追溯交互数据庞大。已有中成药治疗癌症、缺乏癌症登记地区发病率估计、广州帕金森病直接医疗费用、抑郁症支付方式与医疗支出等研究。政策上,国家可信评价点网络、地方试点、海南三医真实世界数据平台、全国智慧医保大赛等,都在打开合规研究通道。但开放模式是“可用不可见”:数据在沙箱中运算,不能导出原始数据,操作全程留痕,导出结果要“过安检”。这意味着研究者不能幻想直接调取国家医保大库,而要学会与可信评价点合作立项,在封闭环境中用R、Python、SQL完成分析。
这次报告对我个人的启示有三点:第一,认真学习方法学理论,尤其是因果推断、倾向性评分、逆概率加权、双重稳健估计和生存分析;第二,坚持问题导向,从临床痛点、医保决策和患者获益中找真问题;第三,合规先行,守住数据安全与隐私保护红线,走官方渠道,不碰原始个体数据。
总之,中国医保真实世界研究正处在从“数据大国”走向“证据强国”的窗口期。国外已遍地开花,国内虽不多却大有希望。我们既要有热情,更要有方法、有敬畏、有合作意识,把合规脱敏的医保数据转化为服务患者、临床和医保决策的高质量证据。
供稿:王小珲
审校:冉竹逸
终审:米白冰
 陕公网安备61011302000964号

 扫码关注公众号

