新闻动态
2026年生物统计学术会议期间,我听了清华大学统计与数据科学系金华清老师的报告《精准医学时代的贝叶斯自适应设计:协变量驱动的历史信息动态借用》。报告围绕一个很实际的问题展开:开展新的临床试验时,既往研究已经积累的患者资料,能否为当前研究提供帮助?如果可以,这些信息又应当如何影响后续的试验设计?
由于自己正在学习贝叶斯自适应随机化,我对报告中的“动态”格外关注。过去,我更多考虑的是根据已经观察到的疗效调整分配概率。这场报告让我进一步认识到,自适应设计还可以围绕两组已有的信息量展开。历史资料是否有参考价值、能补充多少信息,以及新患者应如何分配,需要放在一起考虑。
历史患者很多,不代表可借用的信息就多
报告首先介绍了借用历史信息的研究背景。临床试验需要投入时间和资源,如果能够合理利用既往对照资料,就有机会提高研究效率。但历史数据来自另一项研究,其中的患者构成、治疗条件和观察方式可能与当前试验不同。将两批数据直接合并,样本量虽然增加了,治疗效果的估计却未必更可信。
报告以FIT和HORIZON两项安慰剂对照试验为例,介绍历史数据的应用场景。两项研究分别涉及阿仑膦酸和唑来膦酸,报告中的分析以24个月时的髋部骨矿物质密度为结局,由FIT提供历史资料,HORIZON作为当前试验。两项研究具有相关的临床背景,但能否借用信息,还需要进一步考虑患者特征。
这使我开始注意“有多少历史数据”和“有多少适用的信息”之间的区别。一批资料即使规模很大,如果与当前研究人群差异明显,也不能仅凭例数多就给予很高的权重。历史资料的价值,需要结合当前研究的问题和人群来判断。
把借用落实到具体患者特征
金老师介绍了协变量自适应历史对照借用贝叶斯设计(covariate-adaptive historical control borrowing Bayesian design,CAHB),将历史对照信息的利用与当前试验的患者分配联系起来。报告列出了三个目标:借用历史信息、调整治疗分配比例和平衡协变量。其关键思路是利用历史资料,估计不同患者特征下的对照结局,再针对相应的协变量特征进行局部信息借用。
这里的“局部”,是我理解这项方法的一个切入点。以骨矿物质密度研究为例,报告考虑了跌倒史、椎体骨折史、绝经年限和基线髋部骨矿物质密度四项协变量。对于具有某种特征的患者,模型关注的是与这些特征相关的对照信息,而不是只使用全部历史患者的一个平均值。
我的理解是,历史数据对不同患者提供的参考可能并不相同。有些患者特征在既往研究中较为常见,相关资料相对充分;有些特征对应的资料则较少。用一个总体均值概括所有人,容易掩盖这种差别。将协变量纳入借用过程,可以更细致地描述历史信息适用于哪些患者。
不过,协变量接近也不意味着两项研究完全可比。未记录的预后因素、诊疗条件变化等,仍可能造成差异。因此,协变量提供了判断可比性的依据,却不能代替对数据来源和临床背景的核查。这也是我在理解“动态借用”时,需要保留的一层谨慎。
分配比例背后,还要看两组掌握了多少信息
报告中的设计流程从一段等比例分配开始。随着当前试验资料积累,模型更新相关估计,计算两组在新患者协变量附近的信息量,并结合历史借用带来的信息变化,决定下一位患者的分配。
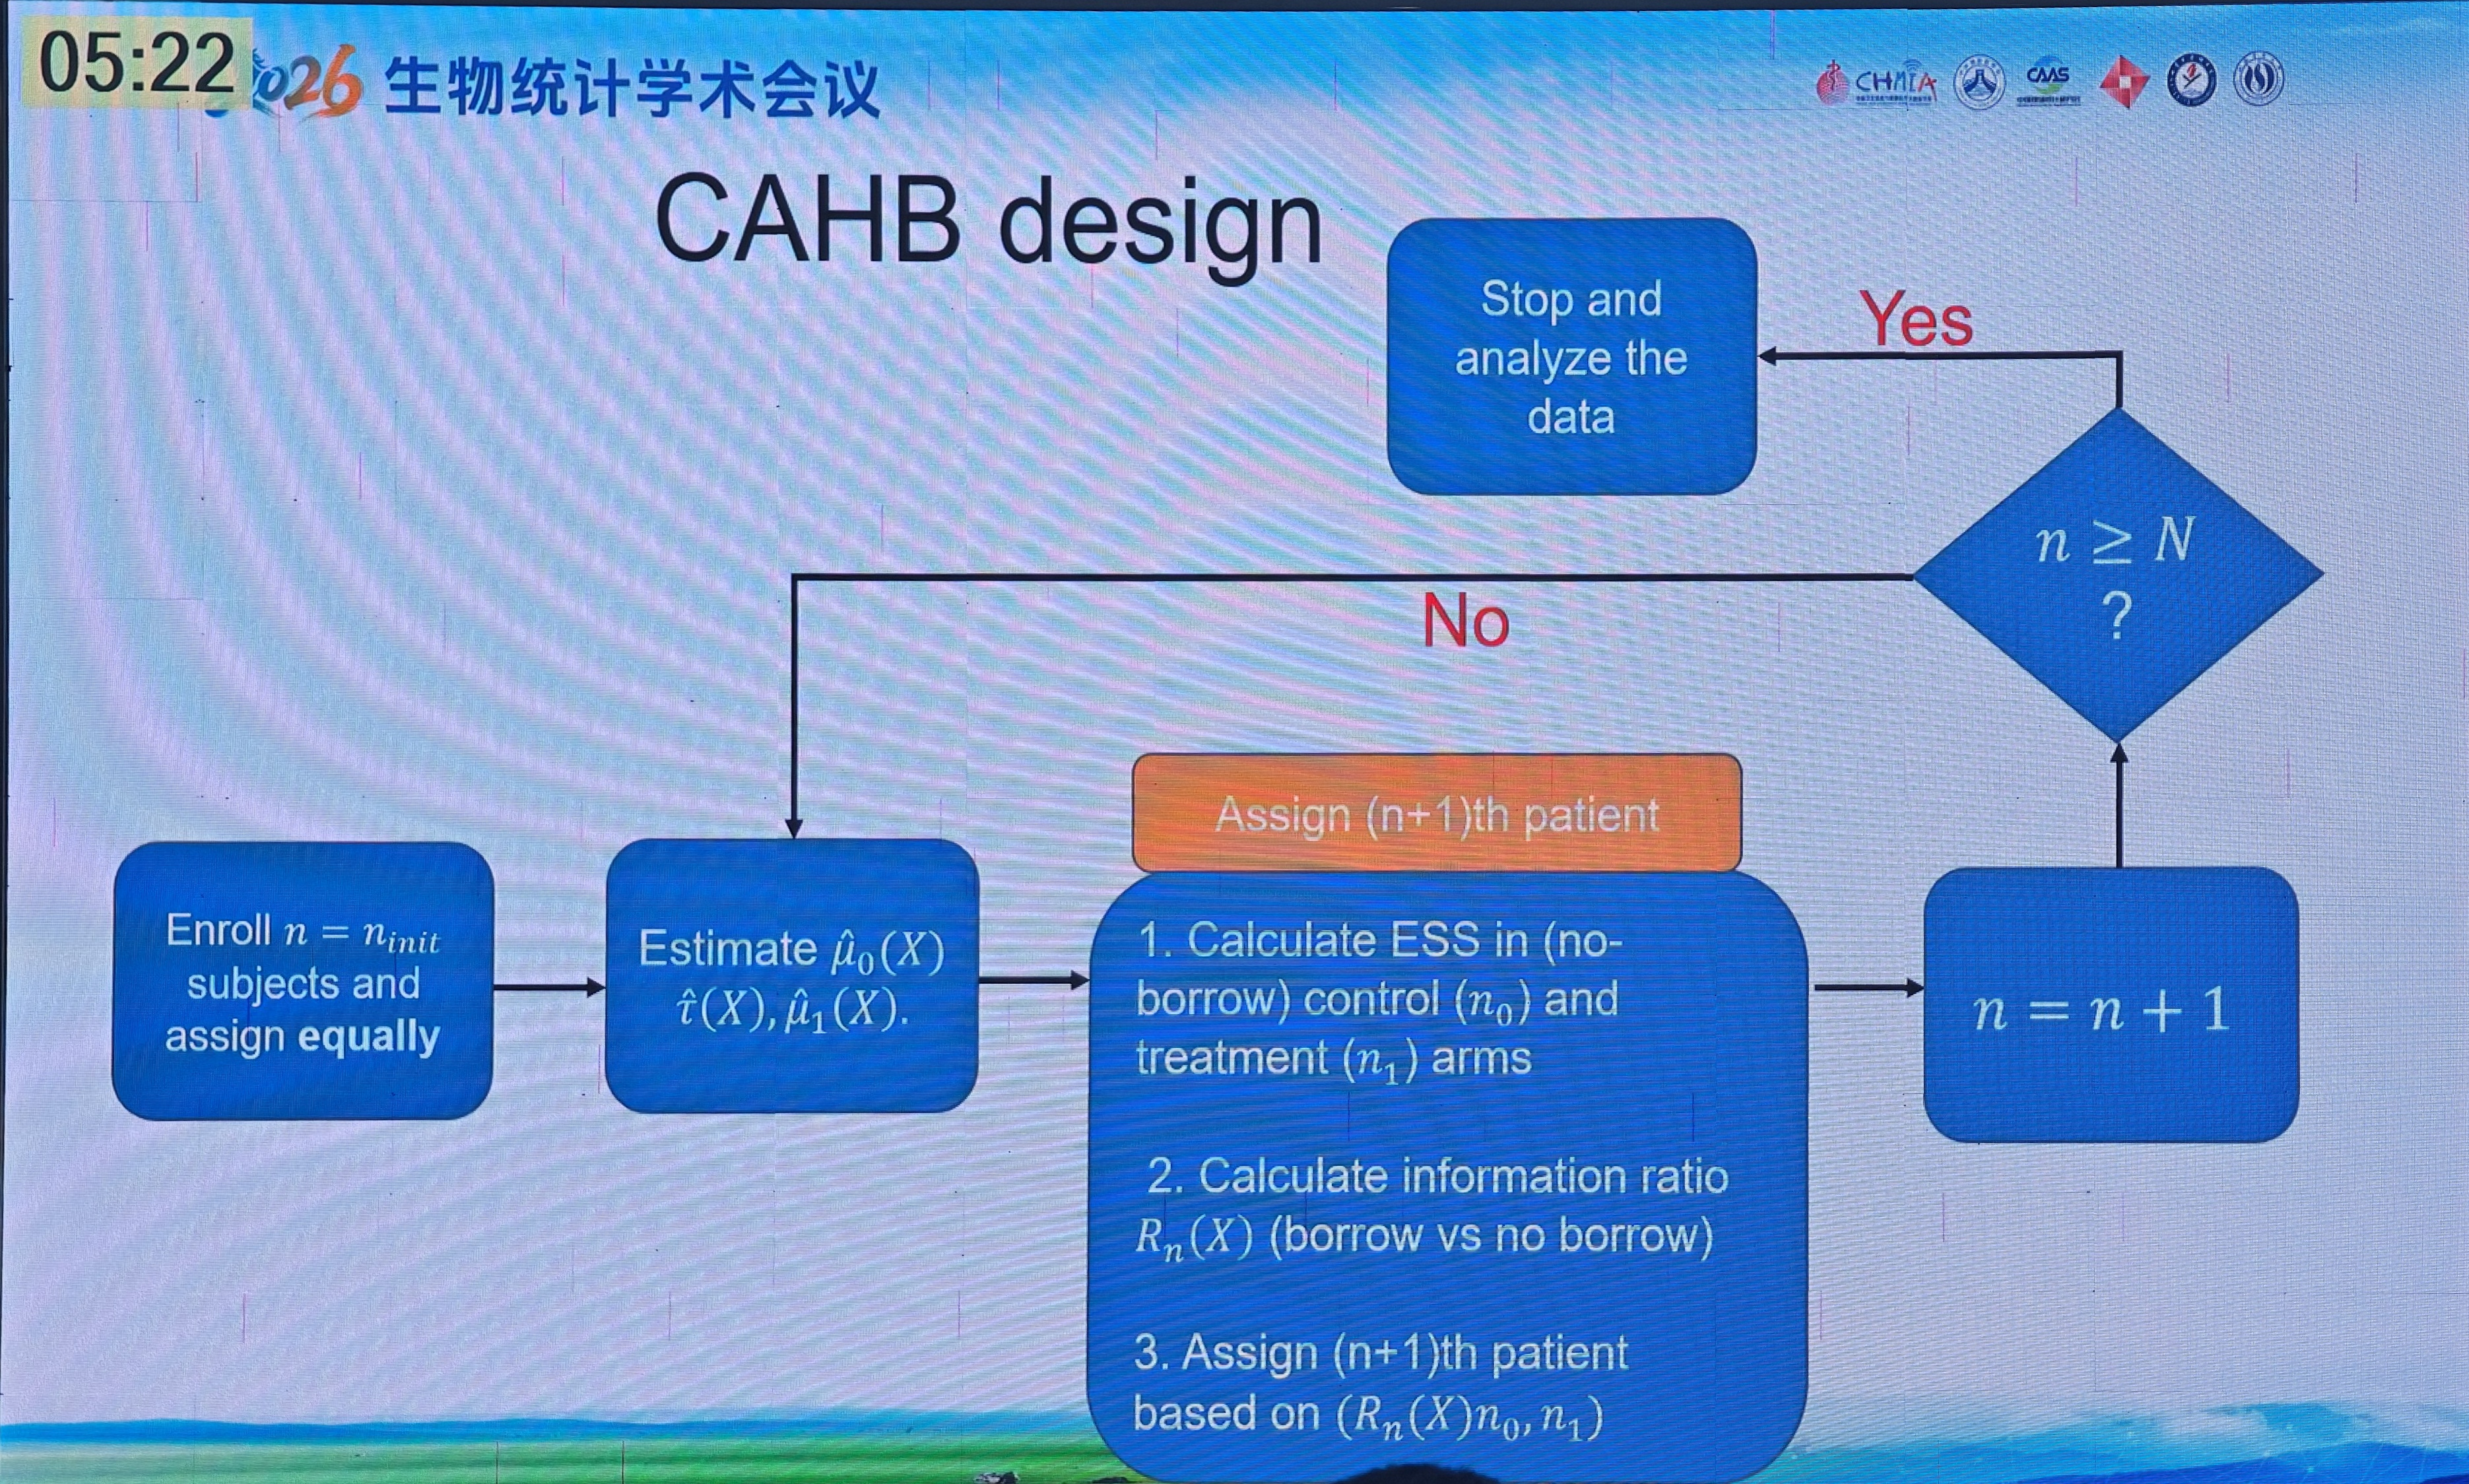
图-1 CAHB设计的序贯分配流程
其中,有效样本量的处理很有启发性。报告根据新患者与当前试验中已入组患者的协变量相似程度赋予权重,分别计算两组的局部有效样本量,再结合历史借用带来的信息增益调整分配。这样,判断两组信息是否充足时,既考虑已经入组的人数,也考虑这些患者的特征与新患者有多接近。
如果历史资料能够为某类患者的对照结局提供较多信息,设计便可以据此调整当前试验中的分配;如果相关信息有限,当前对照组仍需要提供足够的观察。这样,历史借用就与入组过程发生了联系,而不只是研究结束时的一项分析选择。
这一点也帮助我区分了不同自适应方法的出发点。我此前关注的响应自适应随机化,主要依据累积疗效证据调整分配,使更多患者有机会接受表现较好的治疗。报告中的CAHB则把协变量附近的信息量及历史借用纳入分配依据。两者都可能改变分配比例,但理解一种设计时,仍要具体看它根据什么调整、希望改善什么。
读结果时,要把分配、估计和效能放在一起
报告最后展示了2000次模拟的结果,将CAHB与不借用历史信息的基于核函数的偏向硬币设计(kernel-based biased coin design,KBCD)进行比较。图中同时呈现了分配比例、治疗效应估计误差和统计效能随样本量变化的情况。
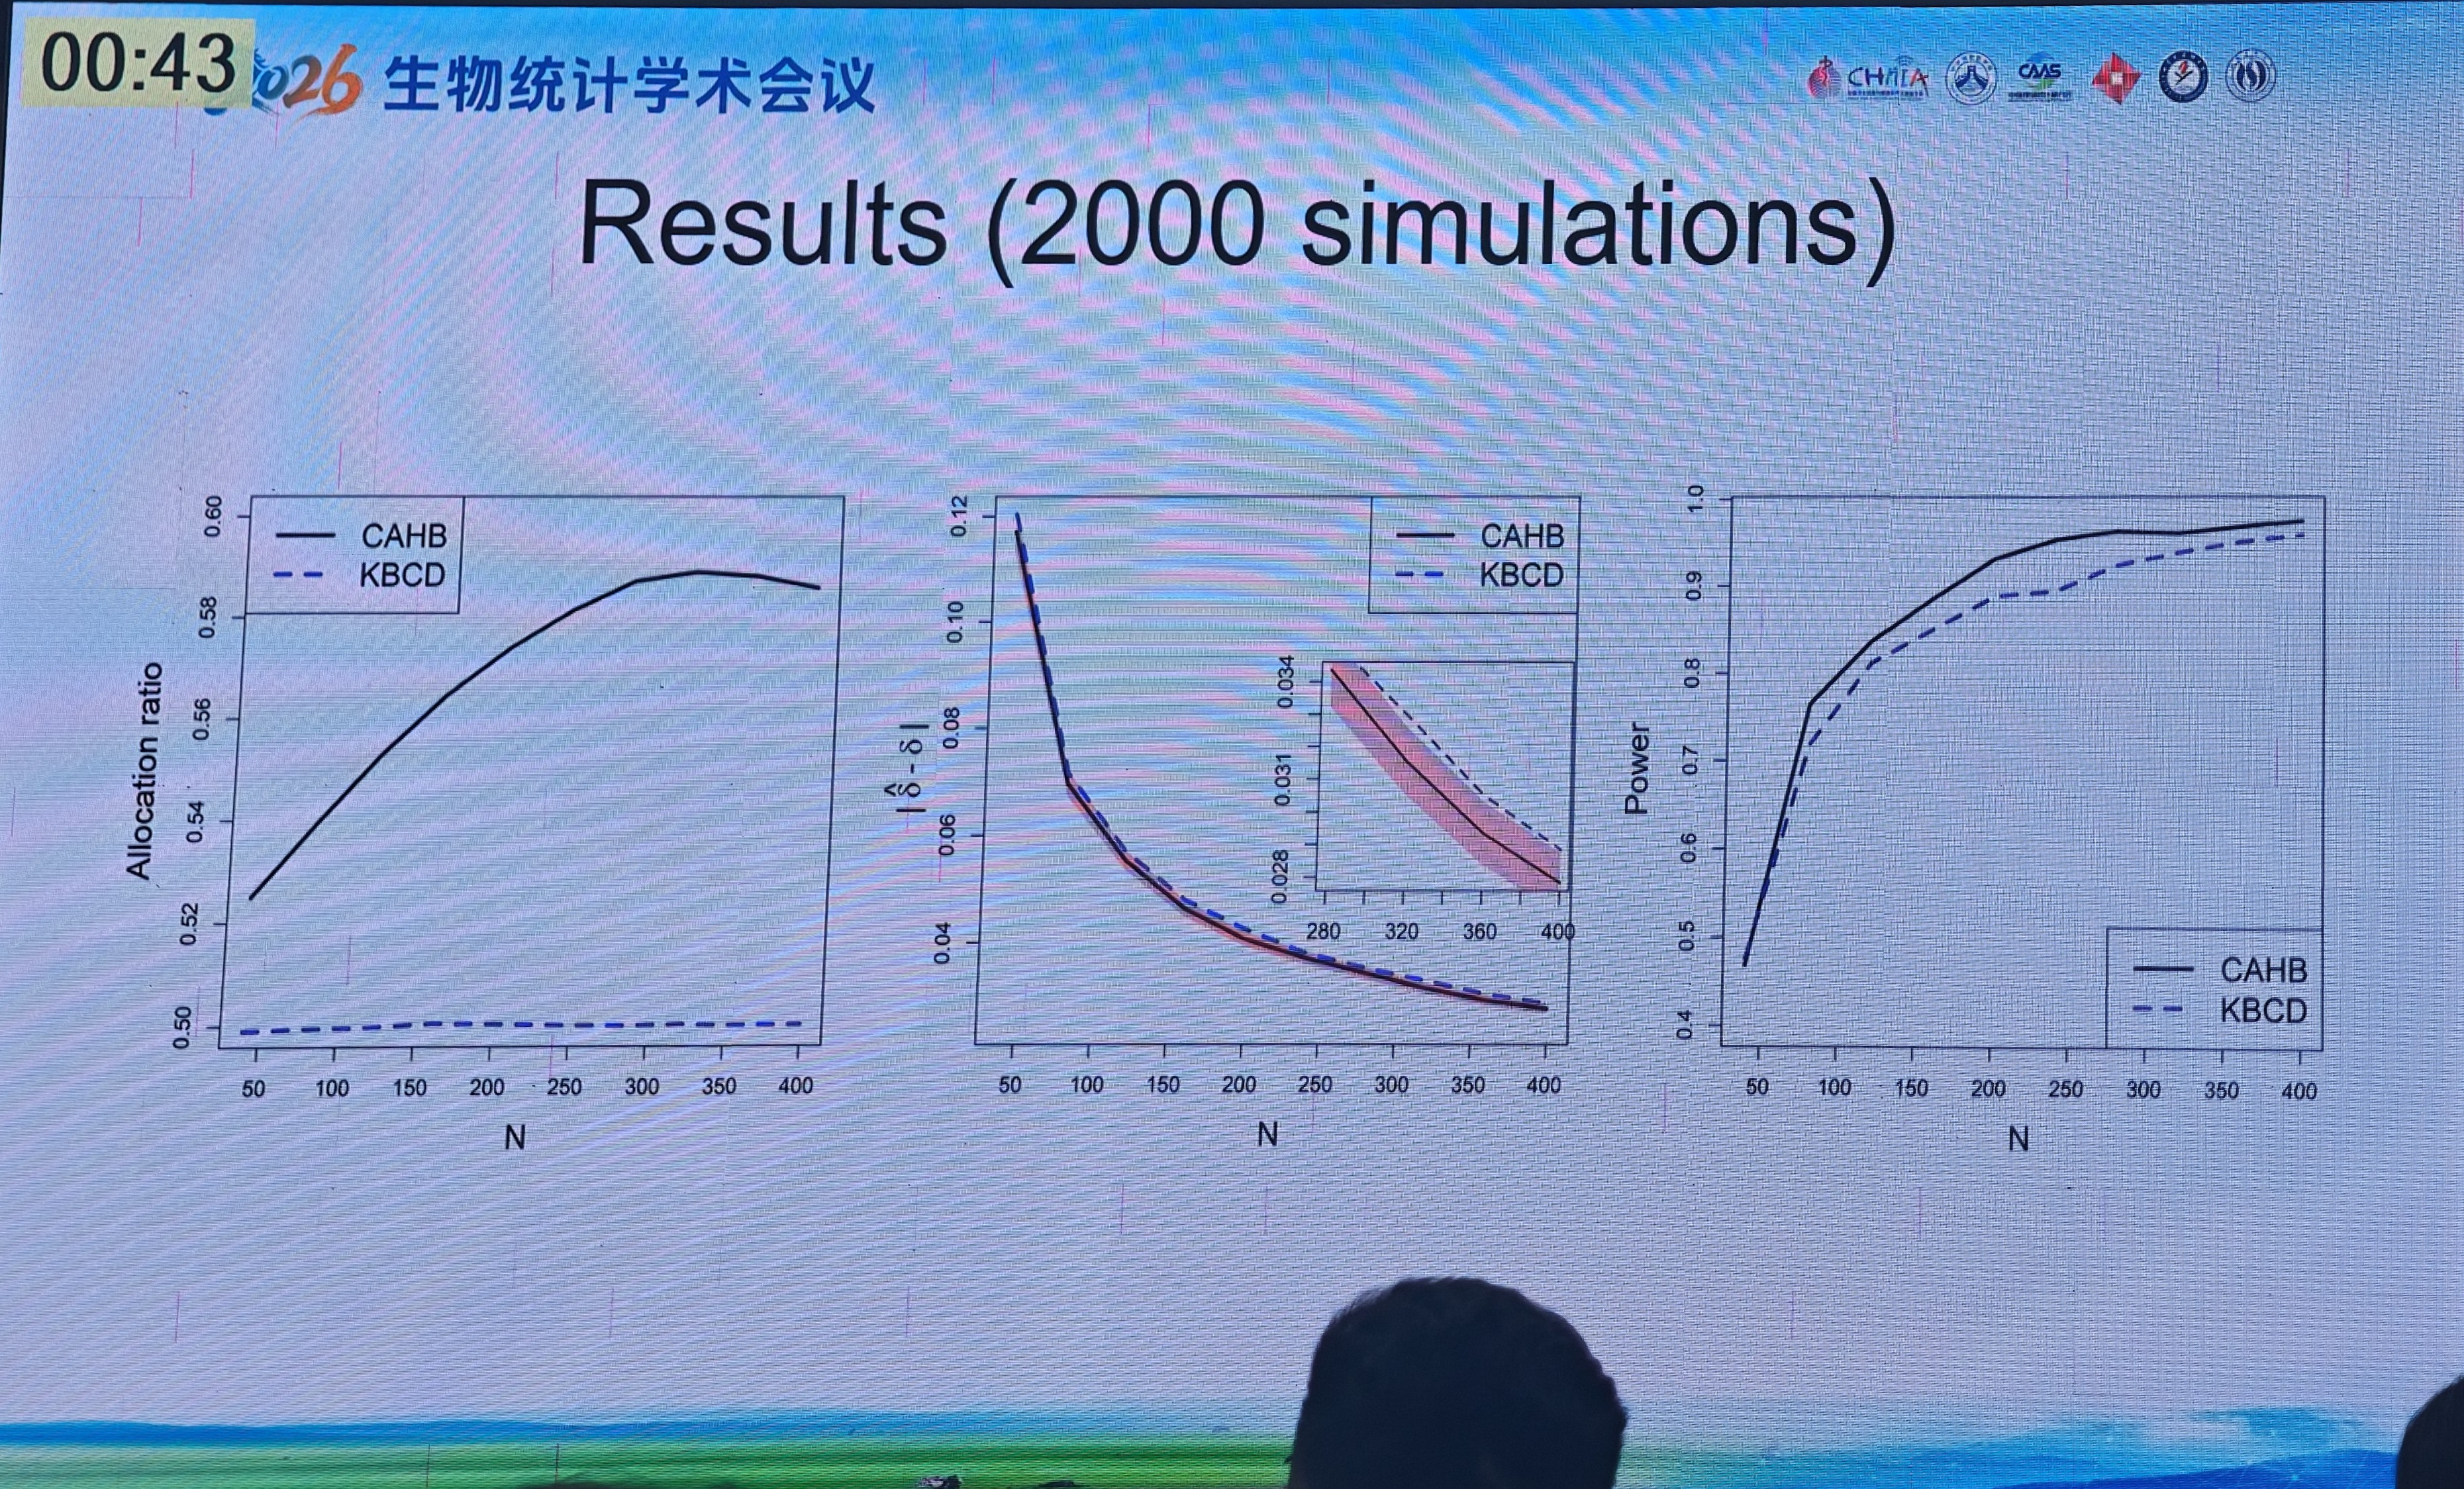
图-2 CAHB与不借用历史信息的KBCD的模拟比较
在展示的情景中,KBCD的分配比例基本保持在一半附近,CAHB则有所提高;随着样本量增加,两种方法的估计误差均下降,CAHB的效能曲线总体高于比较方法。这些结果展示了合理利用历史信息可能带来的效率收益。
我觉得值得学习的,还有这组图的评价方式。仅看到试验组分配比例提高,还不足以判断设计是否更好;需要同时观察治疗效应能否被准确估计,以及检出真实差异的能力是否得到保障。另一方面,这些曲线对应特定的数据和模拟设定,不能直接推导出CAHB在所有情况下都占优势。对我后续的研究而言,还需要主动设置历史资料与当前资料存在差异的情景,检查借用是否带来偏倚,以及无真实治疗差异时是否更容易作出错误判断。
对自己研究的启发
回到目前开展的REDCap与贝叶斯自适应随机化联动研究,这场报告给我的启发首先是把研究目标说清楚。调整分配概率、借用历史信息和保持协变量平衡,彼此有关联,但每项功能都需要有明确的依据和评价指标。增加一个模块之前,应先解释它要解决什么问题,再检验它是否确实带来改善。
其次,历史信息借用对数据管理提出了更具体的要求。后续考虑在平台中实现相关方法,就需要提前核对两项研究的变量定义、编码、测量时间和结局口径,也需要保存每次更新所采用的数据及计算结果。只有这些环节能够对应起来,才能解释某一次分配为什么发生变化,并在出现问题时进行复核。这是我结合自身平台研究产生的进一步思考。
对我目前的研究而言,这场报告提示了一个值得继续探索的方向:在完善贝叶斯自适应随机化执行流程的基础上,进一步考察历史信息能否为当前试验提供帮助。开展这一步之前,需要先明确历史资料的适用范围,并通过模拟检验借用对分配和统计推断的影响。我也因此更注意区分“程序能够运行”和“设计具有合理性”:前者需要核对计算与执行过程,后者则需要在不同情景下评价收益与风险。
供稿:辛联昌
审校:冉竹逸
终审:米白冰
 陕公网安备61011302000964号

 扫码关注公众号

